选中转站的时候,我们很容易先看模型单价:输入多少钱,输出多少钱,缓存命中又能便宜多少。但真正用起来,账单还会受到上下文长度、缓存写入和平台倍率的影响。只看价目表上最便宜的那一栏,不一定能判断实际花费。
尤其是用 GPT-5.6、GPT-6 做多轮编程任务时,如果平台用“长上下文双倍计费”来解释扣款,就值得多问一句:这笔费用来自上游,还是平台自己的定价?
中转服务的上游不一定相同。有的是转发 API Key 对应的请求,有的则是把 Codex 订阅账号的请求包装成兼容 API 的接口。客户端看起来都能用,但背后的收费方式未必一样。
| 费用 | 对应 | 看哪里 |
|---|---|---|
| Codex 订阅与额度 | 套餐内的使用限制,以及适用时的 credits 消耗 | 套餐说明和账号用量页面 |
| 官方 API 费用 | 实际模型和服务档位下,各类 Token 的费用 | 官方 API 价目表与用量记录 |
| 中转站向用户收取的费用 | 平台自己的零售价、倍率及结算规则 | 平台公示价格和完整账单 |
官方的Codex / ChatGPT 定价说明也把套餐使用与 API Key 使用分开说明。使用 API Key,按 API 价格结算;使用订阅套餐,则要看套餐额度和相应的 credits 规则。两边用了同一个模型名字,并不意味着每一项收费都能直接对照。
这里也别走到另一个极端:订阅不是 API 账单,不代表长对话不消耗额度。模型、上下文和任务复杂度都会影响用量。我们要分清的,是用量增加和超过某个阈值后额外加价这两件事。
长上下文,为什么不能直接套 API 规则?
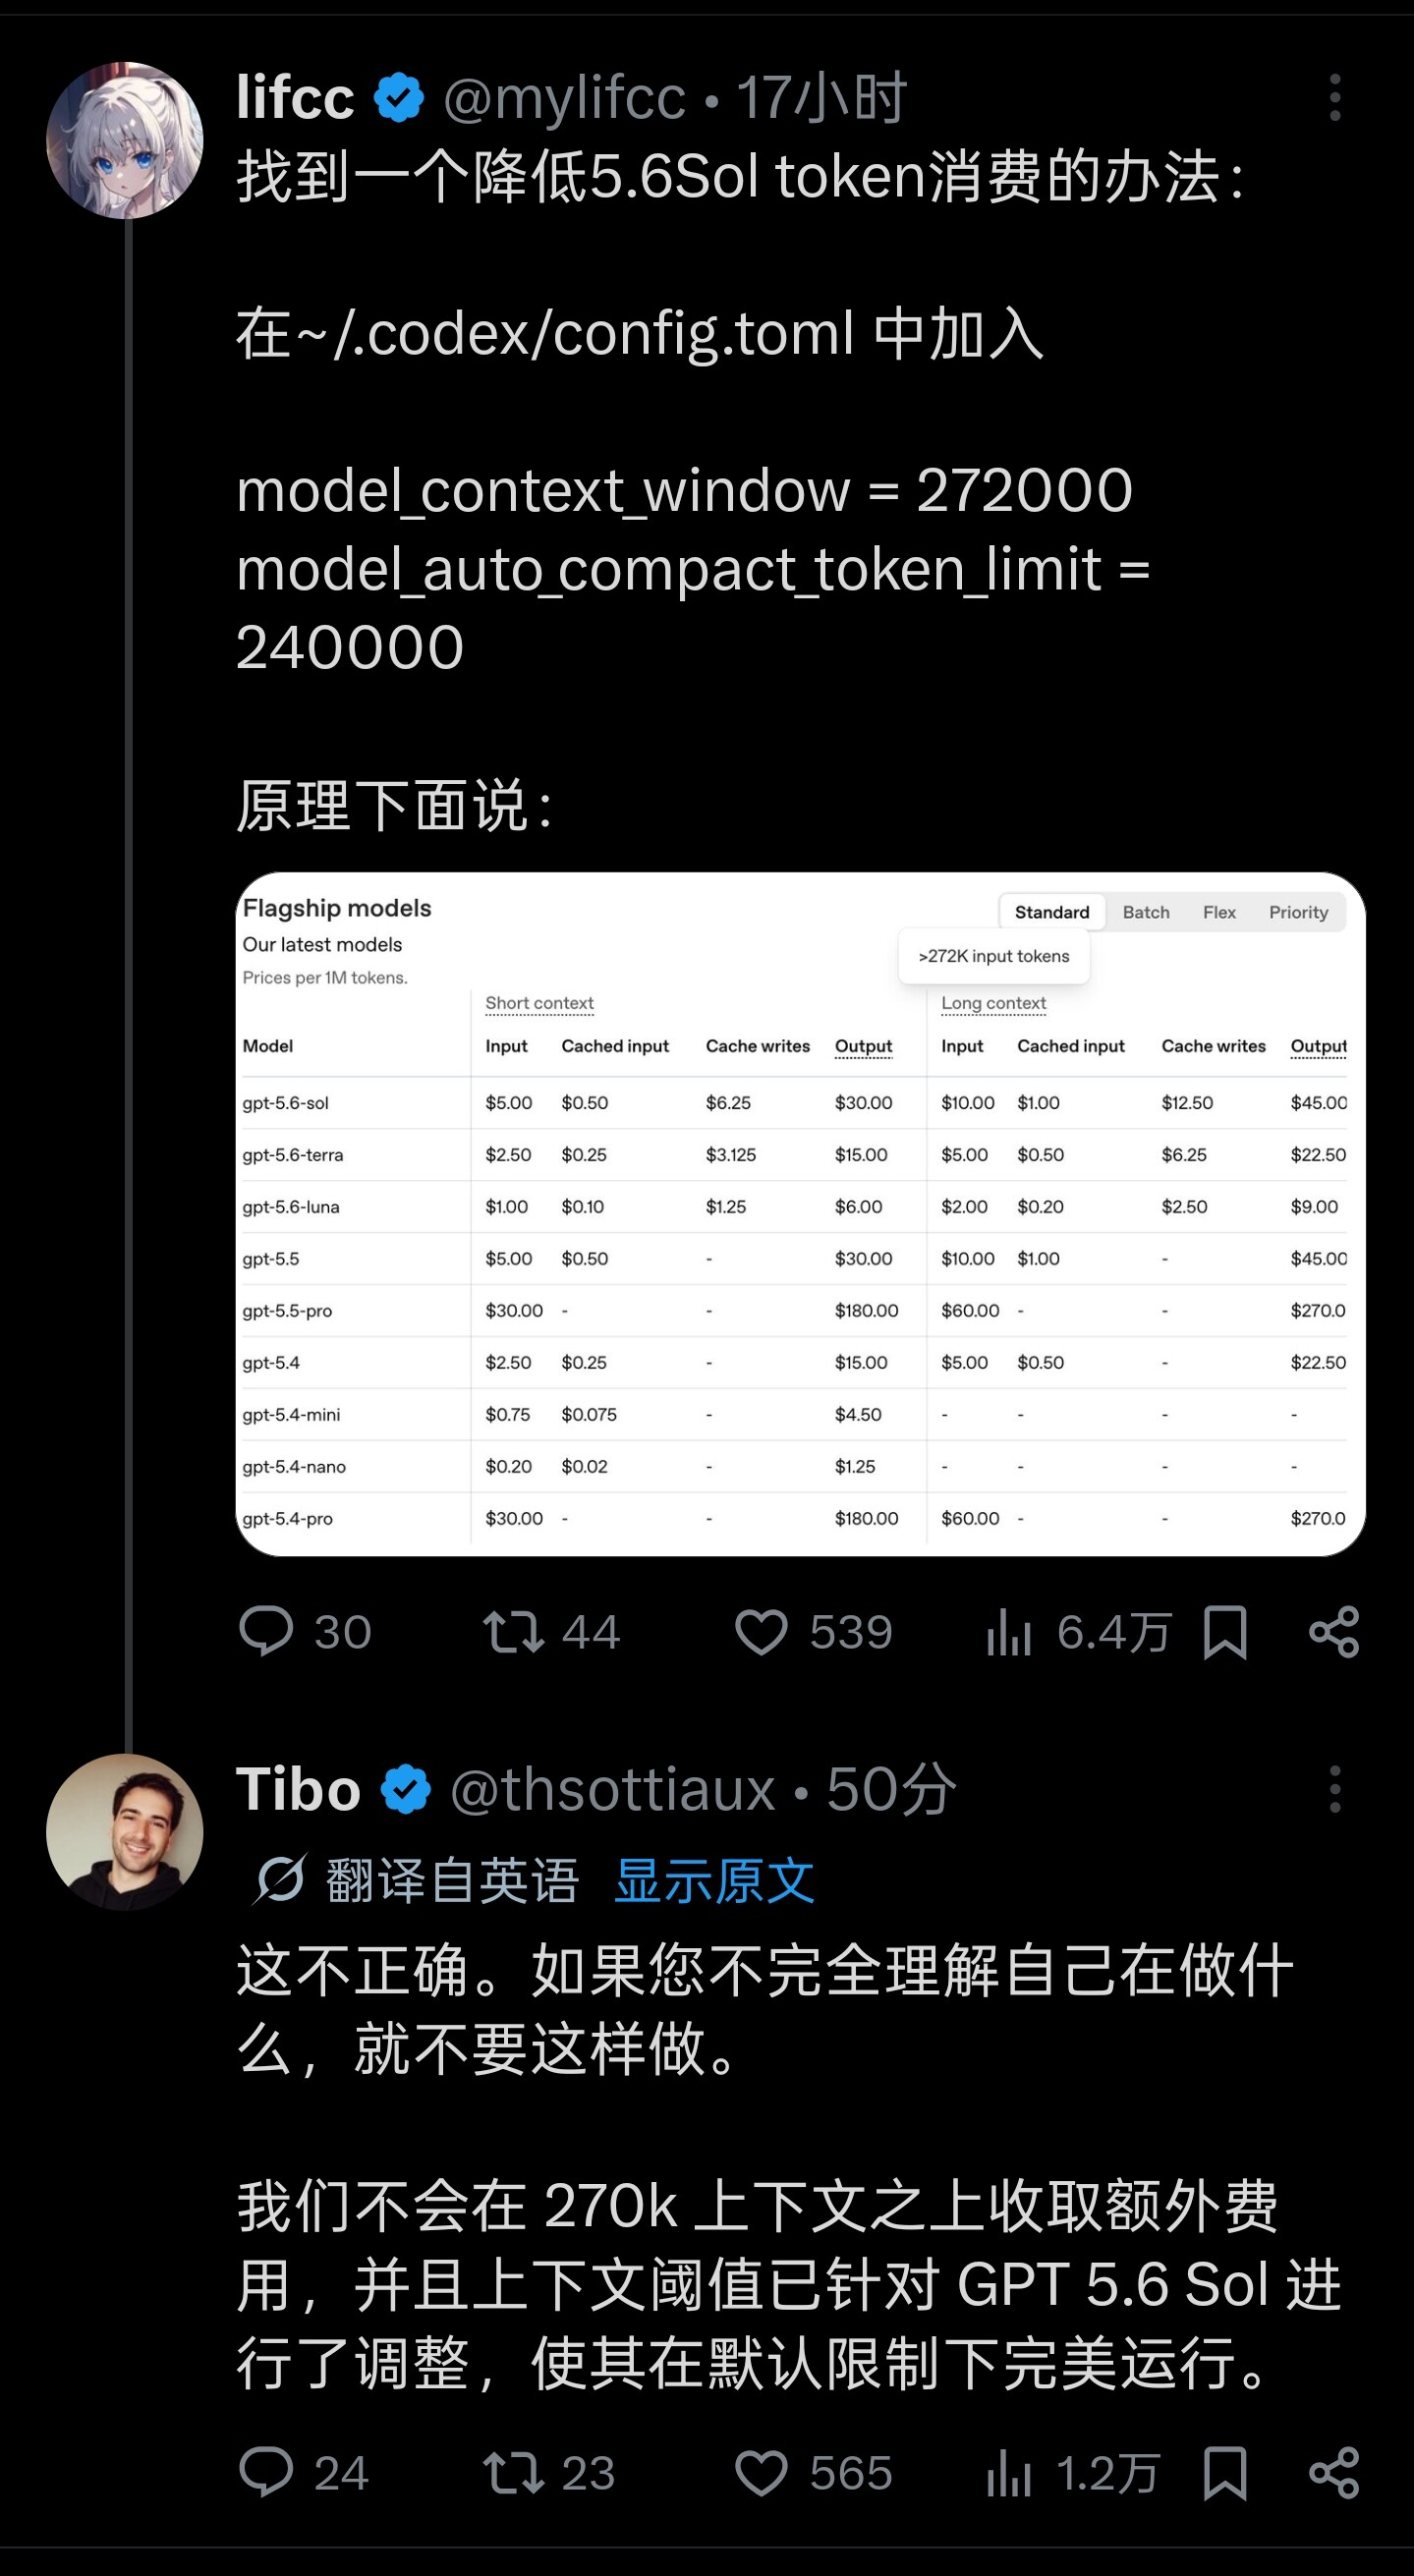
输入超过 272K Token 后,要不要把 API 的长上下文倍率,直接用在 Codex 订阅转发上?
Sub2API 修复,改了什么?
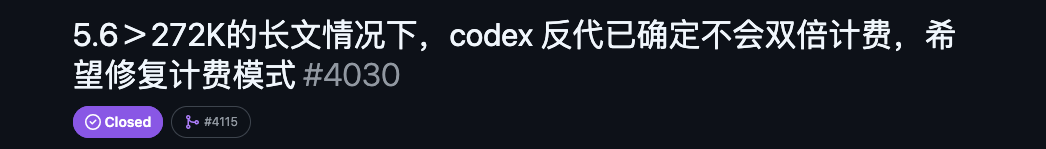
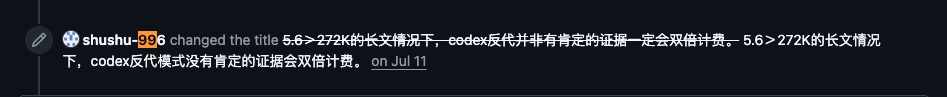
Sub2API Issue #4030创建于 2026 年 7 月 11 日,对应的PR #4115于2026 年 7 月 14 日合并。这两个日期分别是问题提出和修复合并的时间
修复的思路很直接:不再仅凭账号类型就认定要收长上下文费用,而是让管理员按实际的上游规则设置。PR 增加了账号级开关 extra.openai_long_context_billing_enabled,主要有这几处变化:
- OpenAI OAuth、Setup Token 和 API Key 账号的长上下文计费开关默认关闭;上游确实收取对应费用时,再由管理员开启。
- 关闭时,不应用这项功能的长上下文倍率;开启并满足条件时,才按相应倍率计算。
- 使用记录会保存是否实际应用了长上下文加价。在该 PR 描述的实现中,费用因此增加时,页面才显示
x2。
这项改动解决的是长上下文计费控制

参考资料
- Codex / ChatGPT 定价说明:套餐、credits 与 API Key 使用方式。
- OpenAI API 价目表:API 模型价格及计费分项。
- OpenAI 的缓存文档:缓存读取、写入与复用规则。
- Sub2API Issue #4030:这次计费讨论的起点。
- PR #4115:账号级长上下文计费的具体修复。